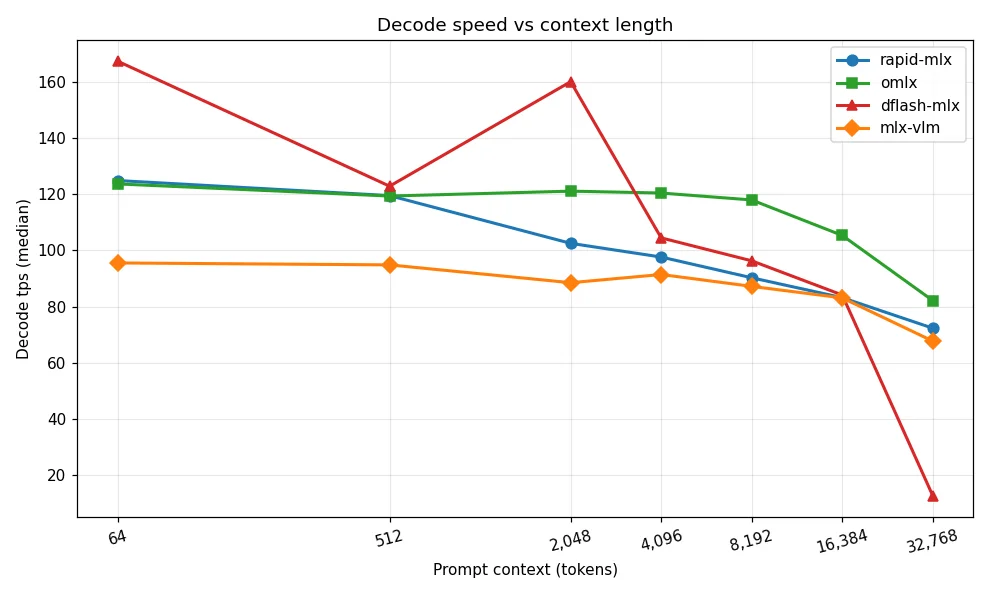
rapid-mlx vs oMLX: MLX Inference Benchmark on Apple M5 Max (35B LLM)
Head-to-head MLX inference benchmark on Apple M5 Max (64 GB unified memory): rapid-mlx vs omlx vs dflash-mlx vs mlx-vlm running a 35B LLM — tokens/sec, time-to-first-token, memory use, and which framework to pick in 2026.
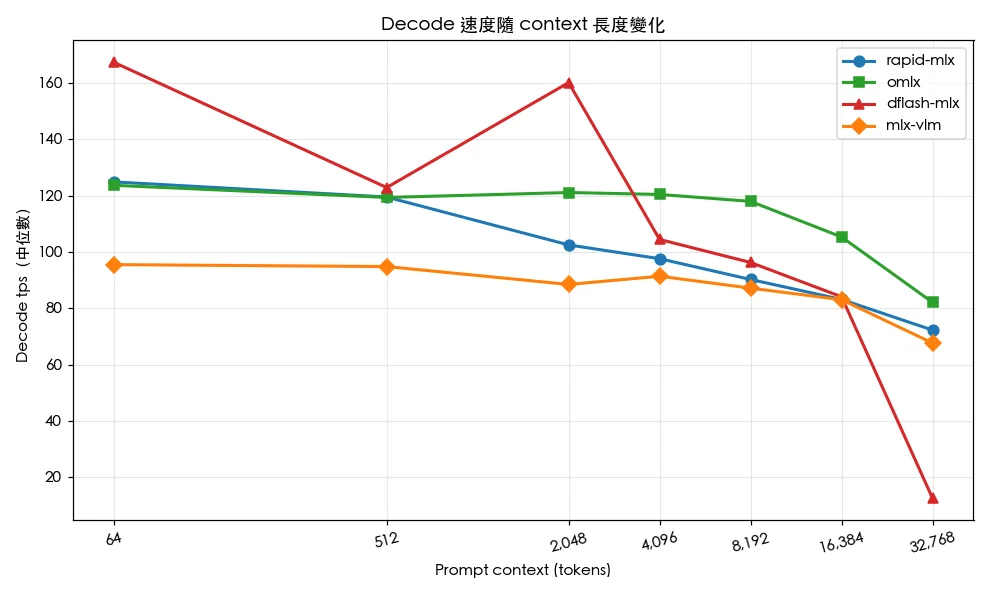
MLX 推論框架基準測試:Apple Silicon M5 Max 跑 35B LLM 實測比較
在 Apple M5 Max(64 GB 統一記憶體)上以 35B 量化 MoE 模型實測 rapid-mlx、omlx、dflash-mlx、mlx-vlm 四大 MLX 推論框架,涵蓋 64 至 32K Tokens 七個上下文長度的解碼速度、TTFT 與穩定度比較,並提供企業地端 AI 選型建議。原始基準測試資料由 ywchiu/mlx_benchmark_lab 開源公開。
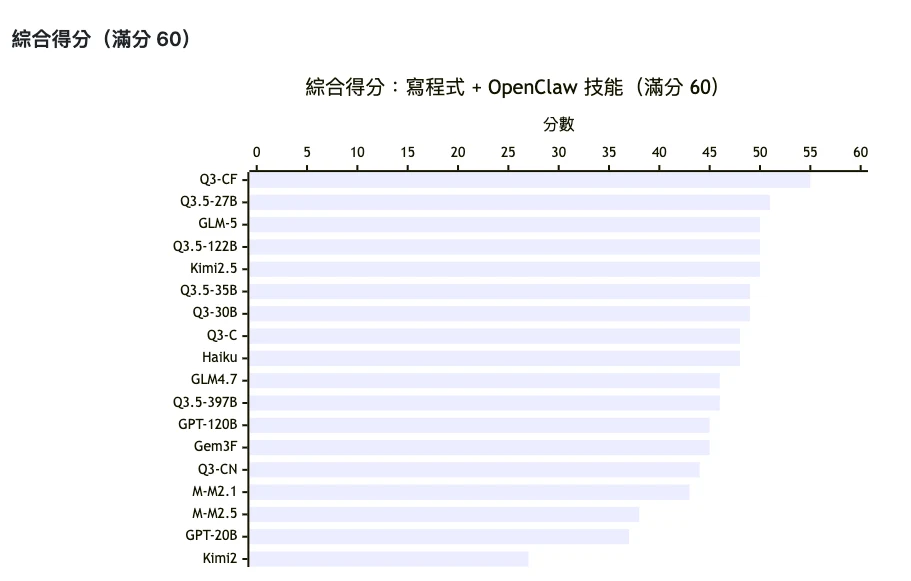
養龍蝦(OpenClaw)選哪個模型好?18 款模型實戰評測
local_agentic_llm 是大數軟體發布的開源 AI Agent 基準測試框架,透過 OpenRouter API 評估 18 款語言模型(15 款開源)在 Agentic Coding 與 OpenClaw 技能建構情境的實際表現。第 1 名 qwen3-coder-flash 以 55/60 分領先(寫程式滿分 30/30),第 2 名 qwen3.5-27b 共 51 分,並列第 3 名 GLM-5、qwen3.5-122b、Kimi-K2.5 各 50 分。qwen3.5 家族稱霸 OpenClaw(G2)前 4 名,得分 26-27 分。性價比最高為 Gemini 3 Flash 與 qwen3.5-27b(G1 均達 25 分,費用僅 $0.09-0.10/次)。本文解析完整排行榜、四象限成本分析與六大任務通過率,協助企業選出最適 AI Agent 模型。
開源 AI 模型比較 2026:Qwen 3.8、DeepSeek V4、GLM 5.3、Kimi K3、Nemotron 選型指南
全面比較 Qwen 3.8、DeepSeek V4-Flash-0731、GLM 5.3、Kimi K3、Nemotron、Muse Glimmer、Gemma 4 與 TAIDE,涵蓋授權、部署、成本、中美路線與台灣企業資安。

Google 研究員表示「我們沒有護城河,OpenAI 也一樣沒有護城河」
Google 研究員表示「我們沒有護城河,OpenAI 也一樣沒有護城河」,文章中,該研究員表示 Google 和 OpenAI 沒有什麼獨特優勢,開源社區正在快速發展 LLM 模型。Google 應該學習和合作,將小型變體納入考慮,更多關注 LoRA 技術,並讓開源為自己工作。