MLX 推論框架基準測試:Apple Silicon M5 Max 跑 35B LLM 實測比較
MLX 推論框架基準測試由 ywchiu/mlx_benchmark_lab 開源專案發布,於 Apple M5 Max(64 GB 統一記憶體)上測試五款 MLX 衍生推論引擎:rapid-mlx、omlx、dflash-mlx、mlx-vlm、MTPLX。前四款以 Qwen3.6-35B-A3B-4bit MoE 模型測試,MTPLX 則以 Qwen3.6-27B-MTPLX-Optimized-Speed(27B dense + MTP depth=3)測試。結果顯示:omlx 在 35B MoE 上為長文脈與企業生產系統首選,從 4K tokens 起全面領先、32K 仍達 82.1 tps;dflash-mlx 短文脈最快(64-token 達 167.3 tps)但長文脈崩潰至 12.6 tps;rapid-mlx 為功能彈性中間選擇;mlx-vlm 為唯一多模態框架。MTPLX 補測顯示 27B + MTP 在 64GB Mac 上可達 32K context、peak memory 僅 22.12 GB,記憶體足跡顯著低於 35B MoE。企業地端 AI 部署應依輸入長度與多模態需求選擇框架,搭配 QubicX 之框架抽象層可自動切換最適合的推論引擎。
原始基準測試資料來源:
github.com/ywchiu/mlx_benchmark_lab
完整 JSONL 結果、繪圖腳本與雙語報告皆於此 Repository 開源公開。
MLX 是 Apple 為自家 Silicon 晶片設計的機器學習框架,能在 Mac 上以統一記憶體(Unified Memory)直接執行大型語言模型(LLM)推論,無需 NVIDIA GPU。隨著 rapid-mlx、omlx、dflash-mlx、mlx-vlm、MTPLX 五大推論引擎陸續推出,企業在地端 AI(On-Premise AI)部署上多了 Apple Silicon 這個極具吸引力的選項。本文以 ywchiu/mlx_benchmark_lab 公開基準測試(Apple M5 Max、64 GB 統一記憶體)為依據,深入解析五大框架在不同上下文長度下的效能與穩定度。前四款框架以 35B 參數 MoE 量化模型測試;第五款 MTPLX 為新增補測,採用其官方推薦的 Qwen3.6-27B-MTPLX-Optimized-Speed(27B dense + MTP)模型,並提供企業地端 AI 選型建議。
什麼是 MLX?Apple Silicon 上的 LLM 推論框架
MLX 是 Apple 機器學習研究團隊在 2023 年底開源的數值運算框架,其核心特色是針對 Apple Silicon(M1/M2/M3/M4/M5 系列晶片)的統一記憶體架構深度優化。與必須在 CPU 與 GPU 之間搬移張量資料的傳統 CUDA 流程不同,MLX 的張量可在 CPU、GPU、Neural Engine 之間零拷貝(Zero-Copy)共享,大幅降低記憶體頻寬瓶頸。這項架構優勢讓配備 64 GB 以上統一記憶體的 Mac Studio 與 MacBook Pro,成為地端執行 30B–70B 參數 LLM 的可行平台。
在 MLX 之上,社群陸續發展出多款專注於 LLM 推論的引擎,每款皆針對不同的應用場景做了取捨。本次基準測試涵蓋的五款主流框架包括:rapid-mlx(功能彈性、支援分頁 KV Cache 與多 Token 預測)、omlx(長文脈穩定度與整體效能均衡)、dflash-mlx(採用推測式解碼 Speculative Decoding,短文脈速度最快)、mlx-vlm(唯一支援圖像、影片、語音多模態輸入的框架)、以及 MTPLX(內建 Multi-Token Prediction 與 prefill-ladder 自動化 context-scaling 基準工具,主打 sustained 高吞吐模式)。
基準測試方法與硬體環境
本次測試使用 Apple M5 Max 晶片搭配 64 GB 統一記憶體。前四款框架(rapid-mlx、omlx、dflash-mlx、mlx-vlm)皆以 mlx-community/Qwen3.6-35B-A3B-4bit,35B 總參數、3B 啟動參數的 4-bit 量化混合專家(MoE)模型進行測試;MTPLX 則以官方推薦的 Youssofal/Qwen3.6-27B-MTPLX-Optimized-Speed(27B dense)測試,啟用 sustained 模式、MTP(depth=3)、disable-thinking、每個 context 生成 128 tokens。所有框架皆透過 OpenAI 相容 API 啟動本地伺服器,並明確關閉 Prefix Cache(前綴快取),以量測真實的冷啟動 Prefill 效能。每個上下文長度執行 5 次重複測試,計算中位數、平均數、標準差。前四款框架測試上下文涵蓋 64、512、2,048、4,096、8,192、16,384、32,768 tokens;MTPLX 為 512、1,024、2,048、4,096、8,192、16,384、32,768 tokens。注意:MTPLX 使用之模型(27B dense + MTP)與前四款(35B MoE-A3B)不同,絕對 decode tok/s 不可直接比較,僅可觀察其 context-length scaling 行為與記憶體足跡。
測試結果:解碼速度與長文脈表現
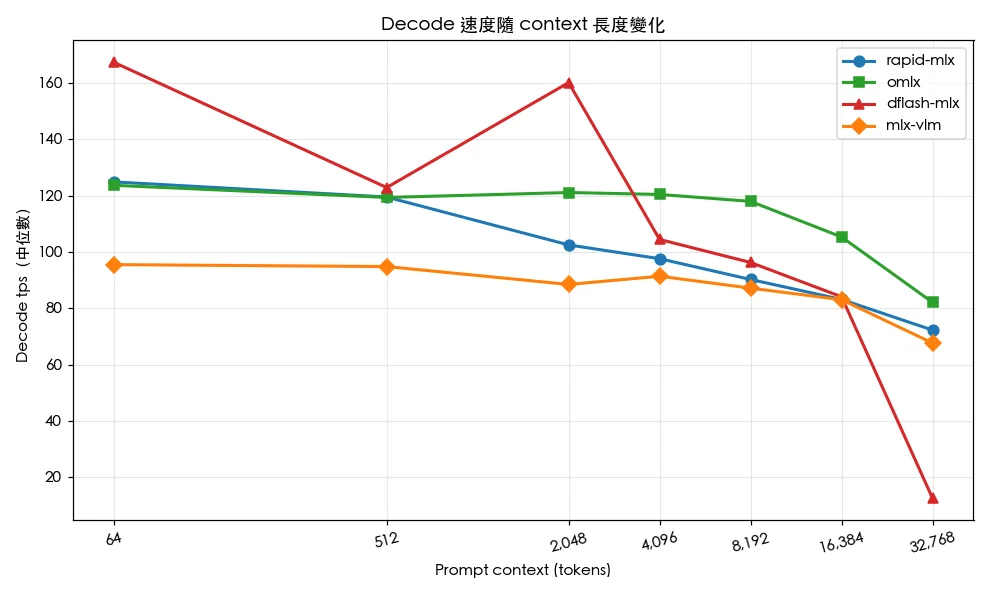
| 上下文長度 | rapid-mlx | omlx | dflash-mlx | mlx-vlm | MTPLX¹ |
|---|---|---|---|---|---|
| 64 tokens | 124.9 | 123.7 | 167.3 | 95.5 | — |
| 512 tokens | 119.5 | 119.4 | 122.9 | 94.8 | 59.8 |
| 1,024 tokens | — | — | — | — | 49.6 |
| 2,048 tokens | 102.5 | 121.1 | 160.1 | 88.5 | 55.7 |
| 4,096 tokens | 97.6 | 120.4 | 104.5 | 91.4 | 43.3 |
| 8,192 tokens | 90.3 | 118.0 | 96.3 | 87.2 | 43.1 |
| 16,384 tokens | 83.2 | 105.3 | 84.1 | 83.1 | 41.4 |
| 32,768 tokens | 72.3 | 82.1 | 12.6 ⚠️ | 67.7 | 31.3 |
單位:tokens/sec(中位數),數字越高越好。資料來源:ywchiu/mlx_benchmark_lab,2026-05-09(前四款)/2026-05-16(MTPLX 補測)。
¹ MTPLX 使用 Qwen3.6-27B-MTPLX-Optimized-Speed(27B dense + MTP depth=3)模型,與前四款 35B MoE-A3B 模型不同,絕對數字不可直接比較,僅供 context scaling 趨勢參考。
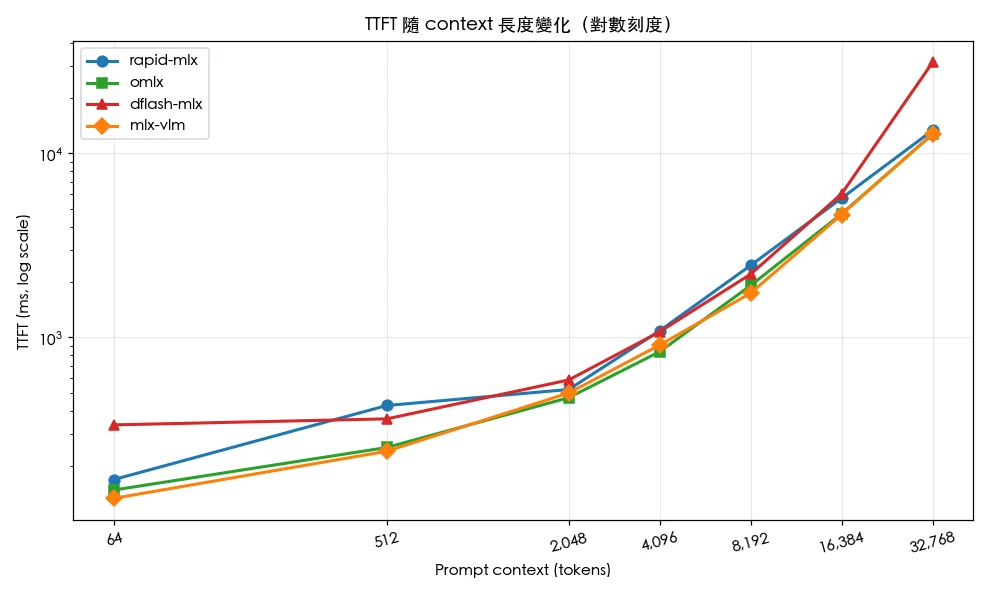
關鍵觀察一:dflash-mlx 在短文脈(≤ 2K)展現約 35% 的解碼速度優勢,這歸功於推測式解碼技術;但在 32K 長文脈下發生災難性衰退至 12.6 tps,比其他框架慢約 6 倍,顯示其架構難以擴展至長上下文。
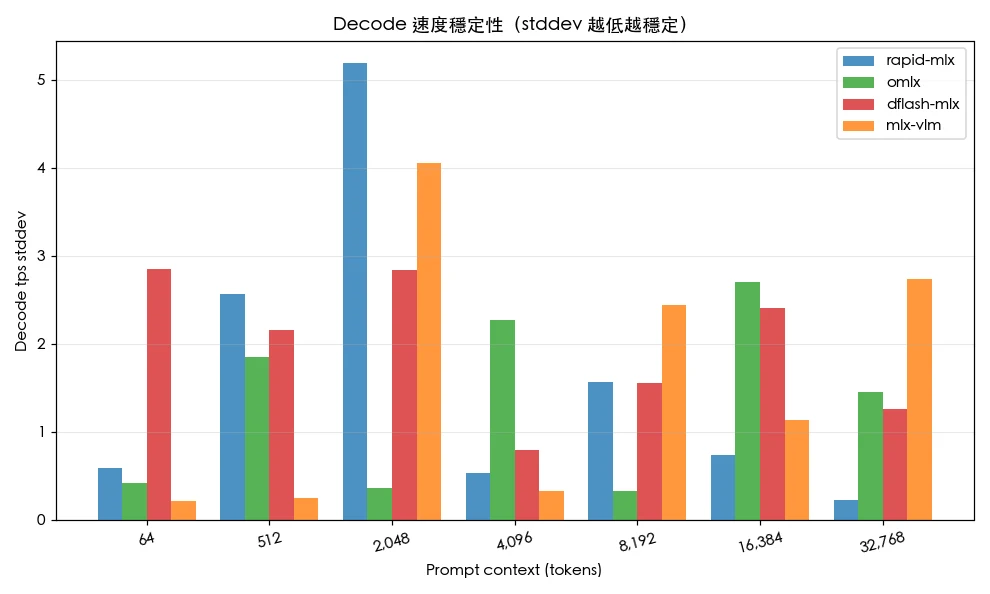
關鍵觀察二:omlx 是長文脈場景的全能冠軍,從 4K tokens 開始全面領先,在 16K 仍能維持 100 tps 以上,32K 達 82.1 tps,且標準差最小,是穩定度最高的框架。
關鍵觀察三:所有框架在從 64 到 32,768 tokens 的擴展過程中皆出現顯著衰退,但衰退程度從 omlx 的 34% 到 dflash-mlx 的 92% 相差極大。TTFT(首 Token 延遲)方面差異更大,跨越近三個數量級:dflash-mlx 在 32K 上下文下飆升至 31 秒,超過其他框架的兩倍。
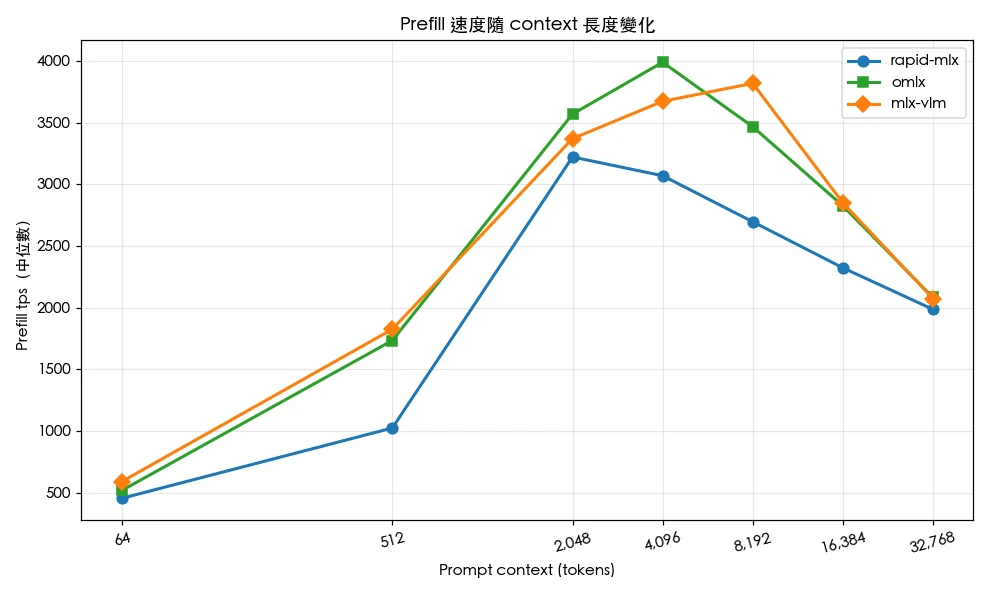
關鍵觀察四(MTPLX 補測):MTPLX 搭配 27B dense + MTP 模型,短 context decode 速度約 50–60 tok/s,到 16K 仍維持 41 tok/s 表現穩定,32K 才下降至 31 tok/s。雖然絕對 tok/s 低於前四款 35B MoE 數字(差異主要來自模型尺寸與架構),但 MTPLX 在記憶體效率上表現亮眼:32K context 下 peak memory 僅 22.12 GB,遠低於 35B MoE 模型常見的 40 GB 量級,為 64GB Mac 保留可觀的多模型併行空間。Prefill 速度從 800 tok/s 平滑下降至 530 tok/s,整體 scaling 較線性。
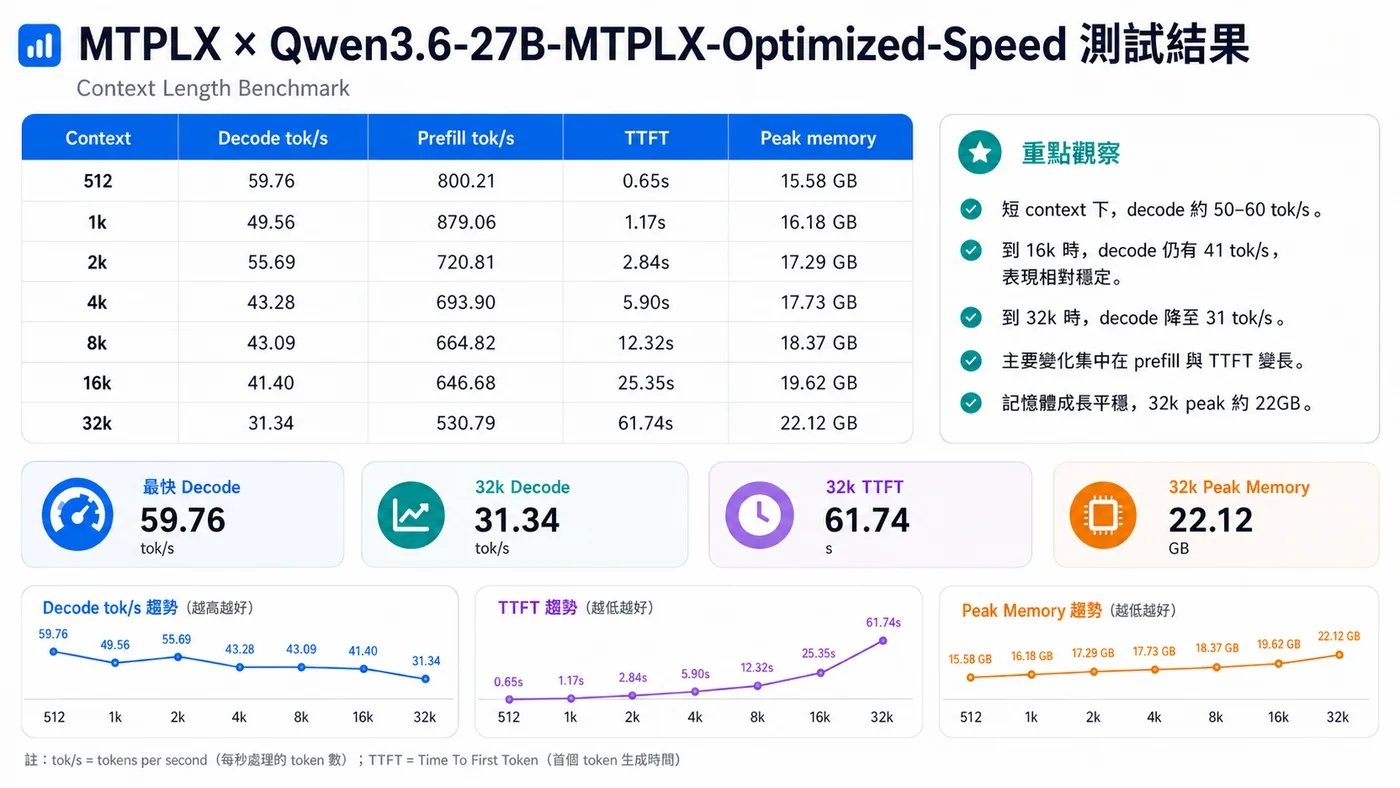
| Context | Decode tok/s | Prefill tok/s | TTFT | Peak memory |
|---|---|---|---|---|
| 512 | 59.76 | 800.21 | 0.65s | 15.58 GB |
| 1k | 49.56 | 879.06 | 1.17s | 16.18 GB |
| 2k | 55.69 | 720.81 | 2.84s | 17.29 GB |
| 4k | 43.28 | 693.90 | 5.90s | 17.73 GB |
| 8k | 43.09 | 664.82 | 12.32s | 18.37 GB |
| 16k | 41.40 | 646.68 | 25.35s | 19.62 GB |
| 32k | 31.34 | 530.79 | 61.74s | 22.12 GB |
MTPLX prefill-ladder 測試:sustained 模式、MTP depth=3、disable-thinking、每 context 生成 128 tokens。資料來源:ywchiu/mlx_benchmark_lab,2026-05-16。
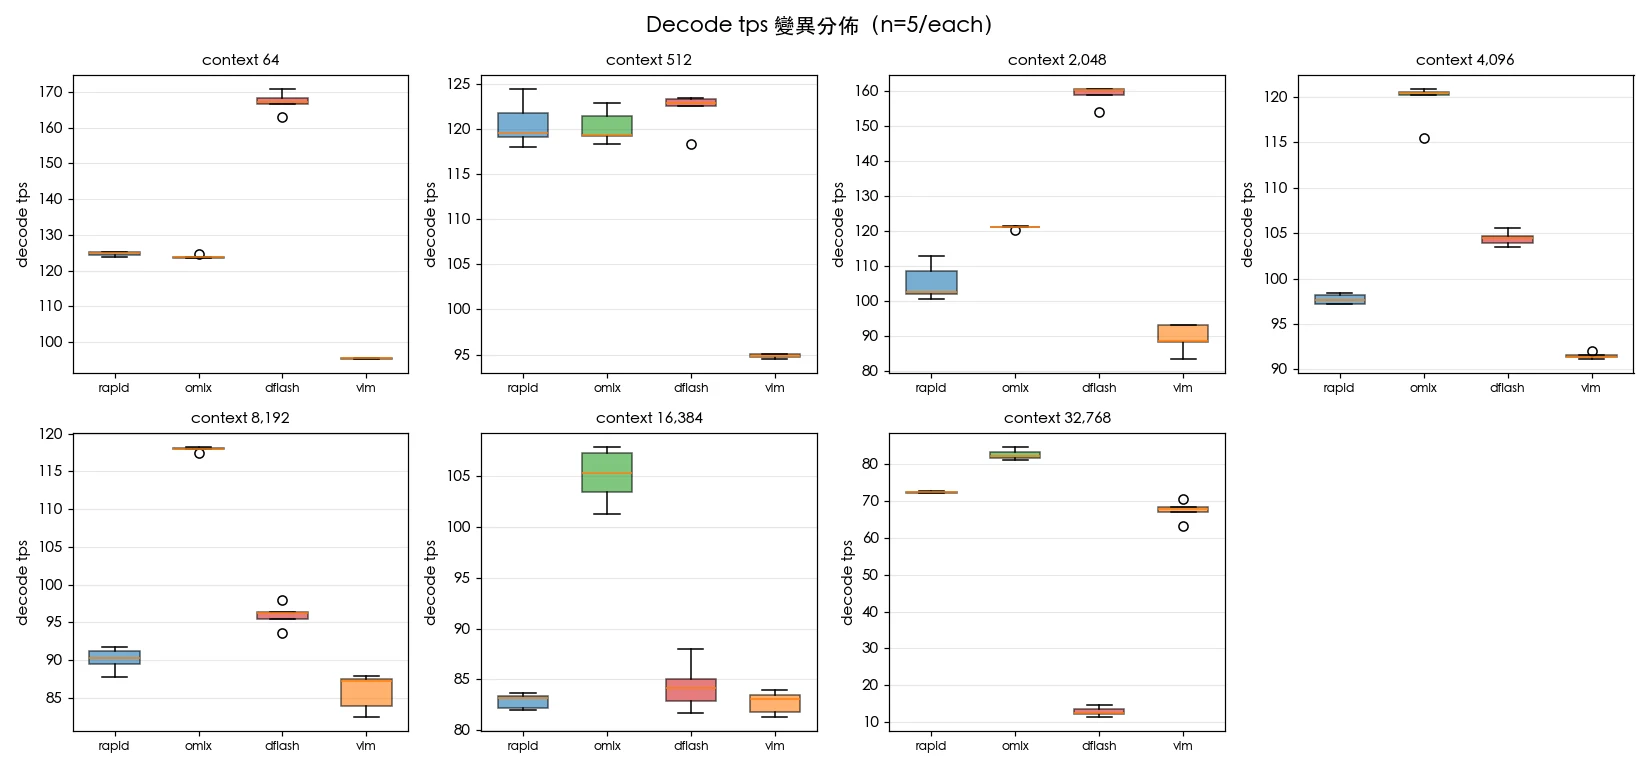
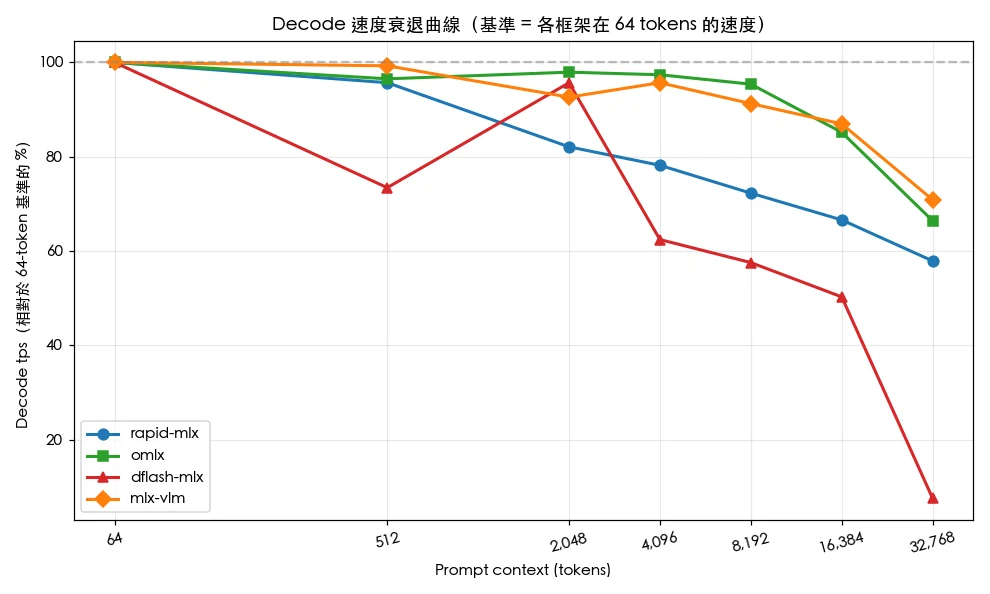
如何選擇適合應用場景的 MLX 框架
omlx — 長文脈與企業生產系統首選:從 4K tokens 起全面領先,且具備四大框架中最低的標準差,是企業 RAG、文件摘要、長篇法律或財報分析的最佳選擇。穩定度高代表 SLA 容易達標,可預測的延遲表現也讓容量規劃更為直觀。
dflash-mlx — 短文脈高吞吐專用:在 64-token 上下文達到 167.3 tps 的爆發力,適合輸入長度可預測且明確控制在 2K tokens 以下的應用,例如結構化資料分類、SQL 生成、簡短客服回覆。但須嚴格避免長上下文場景。
rapid-mlx — 功能彈性的中間選擇:在任何上下文長度都不是最快,但表現相對穩定,且具備分頁 KV Cache、Prefix Cache、多 Token 預測等彈性功能。適合需要這些進階特性的研發團隊。
mlx-vlm — 多模態輸入唯一選項:純文字工作負載慢約 25–30%,但是四大框架中唯一支援圖像、影片、語音輸入的框架。如果應用需要 OCR 後影像理解、視訊摘要、或多模態客服機器人,是當前唯一選擇。
MTPLX — Multi-Token Prediction 高吞吐推論:內建 prefill-ladder 自動化基準工具與 MTP 加速機制,搭配其官方 Optimized-Speed 系列模型(如 Qwen3.6-27B-MTPLX-Optimized-Speed)能在 27B 規模實現 32K context、peak memory 僅 22 GB 的低足跡推論。適合需要在單台 Mac 上同時運行多個 27B 級模型、且輸入長度可預測的 sustained 推論服務;不過模型生態目前以官方 Optimized-Speed 變體為主,模型可選性較窄。
該買哪一台 Mac:記憶體容量與頻寬怎麼抓
基準測試回答的是「跑得多快」,但多數讀者接下來的問題是「那我該買哪一台」。Apple Silicon 的選型其實只有兩個變數真正重要:統一記憶體的容量,以及記憶體頻寬。容量決定模型放不放得進去,頻寬決定放進去之後每秒能吐出多少字。
以目前的產品線來說,搭載 M3 Ultra 的 Mac Studio 記憶體頻寬為 819 GB/s,Apple 規格頁列出的統一記憶體上限為 512 GB(M4 Max 機種則是最高 128 GB、546 GB/s)。實際可選的配置請以下單當下的官方商店為準。這個組合的意義是:容量足以容納單張 GPU 放不下的模型,但頻寬只有資料中心級加速卡的一小部分。
MoE 模型才是統一記憶體的甜蜜點
這正是本文測試選用量化 MoE 模型的原因。先界定範圍:以下談的是解碼階段,也就是逐字生成的過程,這個階段通常受記憶體頻寬限制;處理輸入的 prefill 階段則是高度平行的運算,瓶頸多半在算力,長輸入短輸出的工作負載不適用這個推論。在解碼階段,dense 模型每產生一個 token 都要把整組權重從記憶體讀過一遍,速度幾乎直接被頻寬綁死;MoE 模型則把參數拆成許多專家,每個 token 只啟用其中一小部分,需要讀的資料量遠小於模型的總大小,低頻寬的懲罰因此小很多。要注意 MoE 的權重仍然必須完整放進記憶體,啟用參數少不代表佔用少。
具體對照可以看三組數字。Gemma 4 同時提供 31B dense 與 26B-A4B 兩種版本,總參數量接近,但後者每個 token 只讀約 4B;Qwen3-235B-A22B 是 235B 總參數、每個 token 啟用約 22B;DeepSeek R1 則是 671B 總參數、約 37B 啟用。以 Qwen3-235B-A22B 為例,官方 GGUF 的 Q4_K_M 檔案約 142 GB,256 GB 以上的機器放得下,並留有 KV cache 的空間。
所以選購的第一個問題不是買哪一台,而是要跑 MoE 還是 dense。要跑大型 MoE,Mac 的大容量統一記憶體是性價比很好的一條路;要跑 dense 的 70B 級模型而且在意回應速度,同樣的預算放在高頻寬的 GPU 上會更值得。
記憶體要配多少
抓法是模型權重加上 KV cache 的成長空間。權重約等於參數量乘以每個參數的位元組數,4 bit 量化約 0.5 byte、FP16 約 2 bytes;KV cache 會隨上下文長度與併發數成長,短上下文、低併發時可先以權重的 1.2 至 1.5 倍起算,長上下文則要另外估算。對照到實際配置:64 GB 適合 30B 級量化模型的單人使用;128 GB 能容納中型 MoE(例如 Gemma 4 26B-A4B 這一級)與量化後的 70B;要跑 Qwen3-235B-A22B 這種等級的大型 MoE,光權重就約 142 GB,要 256 GB 起跳才有餘裕再放長上下文的 KV cache。
什麼時候該回到 GPU 伺服器
Mac 的限制不在硬體本身,而在兩件事:頻寬與生態。頻寬的影響前面已經談過;生態的部分是,CUDA 工具鏈在 Apple Silicon 上完全不適用,實務上主要走 MLX 或 llama.cpp,也就是本文比較的這幾套框架。vLLM 已有官方維護的 vLLM-Metal 外掛可在 Apple Silicon 上執行,但支援的模型與功能仍窄於 CUDA 版;TGI 則沒有 Metal 支援,且該專案已於 2026 年 3 月被封存。
分界大致可以這樣抓:單人或小團隊做開發、驗證與內部工具,Mac 是安靜、低耗電、成本可控的好選擇;一旦要讓數十人同時線上使用,或是要跑 dense 大模型並保證回應時間,就該回到高頻寬的 GPU 方案。如果正在做這個層級的評估,我們另有一頁逐層說明地端 AI 伺服器的四種級距、代表機種與機房條件,可以搭配本文的框架選型一起看。
對企業地端 AI 部署的啟示
企業地端 AI 部署的關鍵啟示是:硬體與軟體必須整體評估,不能只看 GPU 規格表面上的 TFLOPS 數字。Apple Silicon 在統一記憶體架構下,搭配正確的 MLX 框架,能以更低的硬體成本(單台 Mac Studio 約 USD 4,000)跑得動 35B 參數的量化模型,並達到 80–120 tokens/sec 的解碼速度,這對許多企業內部的 RAG 或智慧客服場景已經足夠。
相較於 NVIDIA H100 動輒 USD 30,000 以上的單卡成本,Apple Silicon 為中小企業與分散式部署提供了極具吸引力的另一條路徑。但企業若要將 Apple Silicon 納入正式生產環境,必須建立框架選型、版本管理、健康檢查、效能監控的完整 MLOps 流程。
LargitData 的 QubicX 地端 AI 平台支援多種硬體後端(NVIDIA GPU、AMD GPU、Apple Silicon),並內建框架抽象層,能依據用戶提交的上下文長度自動選擇最適合的推論引擎,避免企業 IT 團隊需要自行判斷與切換。對於追求資料主權、低延遲、可預測成本的台灣企業,這類自動化的地端 AI 編排能力,是從基準測試走向生產部署的關鍵橋樑。
完整原始 JSONL 結果、繪圖腳本(plot_results.py)、雙語報告皆已開源公開,歡迎在自家 Mac 上重現驗證: github.com/ywchiu/mlx_benchmark_lab